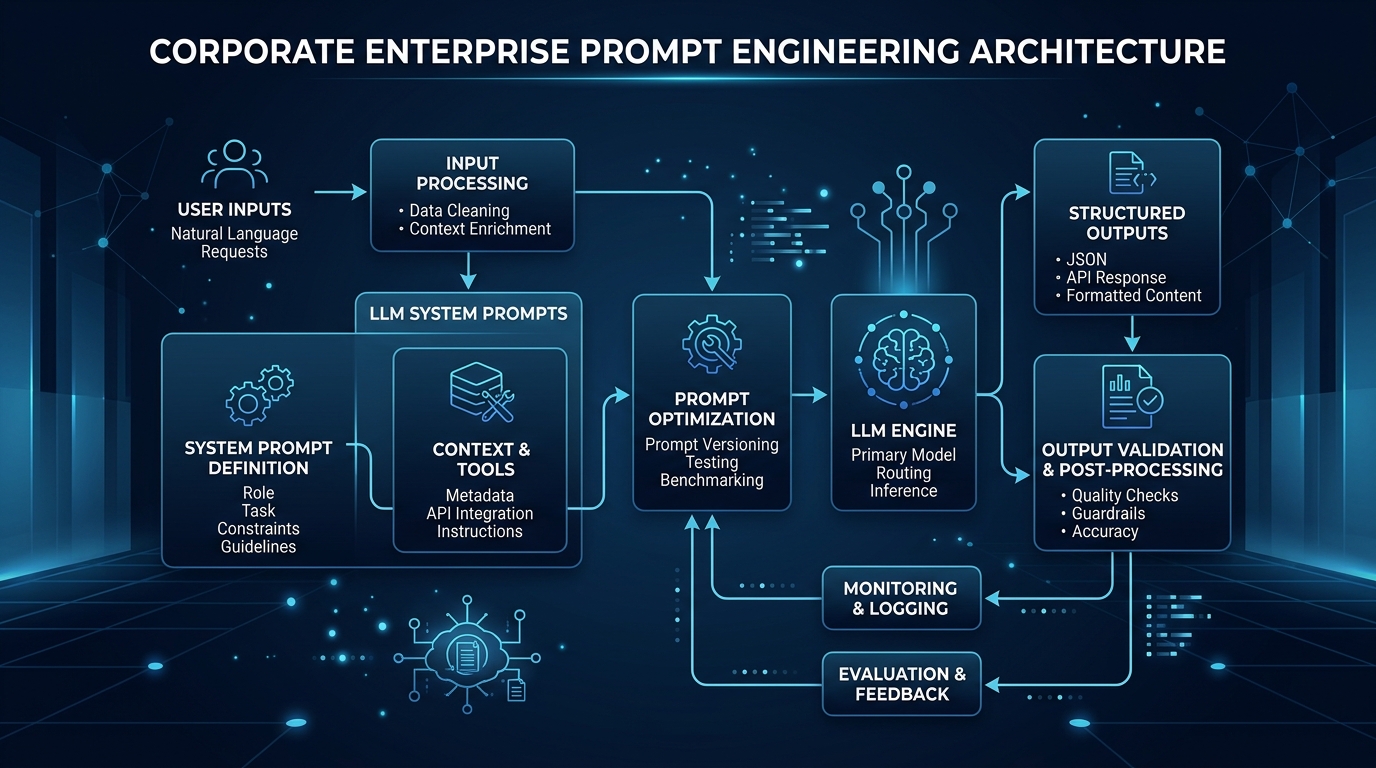
Tratar Grandes Modelos de Linguagem (LLMs) como simples interfaces de chat em ambientes corporativos é o equivalente moderno a implantar um banco de dados relacional sem índices, utilizando consultas dinâmicas concatenadas via string em plena produção. Enquanto protótipos baseados em prompts soltos e ad-hoc encantam stakeholders em apresentações de diretoria, a realidade implacável da engenharia de software cobra o seu preço assim que o sistema enfrenta tráfego concorrente, mutabilidade de estado e o caos inerente aos dados não estruturados gerados por inferências probabilísticas.
A promessa de construir aplicações resilientes baseadas em IA generativa exige abandonar o amadorismo textual e abraçar a engenharia de prompt corporativa. Isso significa tratar prompts não como textos estáticos, mas como artefatos de código versionáveis, sujeitos a contratos estritos, padrões de design arquitetural bem definidos, validação em tempo de execução e monitoramento contínuo de SLOs. Quando o modelo falha em retornar um JSON válido ou alucina campos críticos em uma fatura financeira automatizada, o custo não é apenas estético — é um prejuízo operacional direto.
Construir infraestruturas de IA em escala industrial exige mapear os gargalos de latência, mitigar a degradação de contexto e implementar barreiras de segurança algorítmica. O abismo entre um script experimental em Python que chama a API de um provedor de LLM e um pipeline de produção resiliente reside na maturidade do ecossistema de engenharia ao redor do modelo.
O colapso dos contratos de dados em tempo de inferência
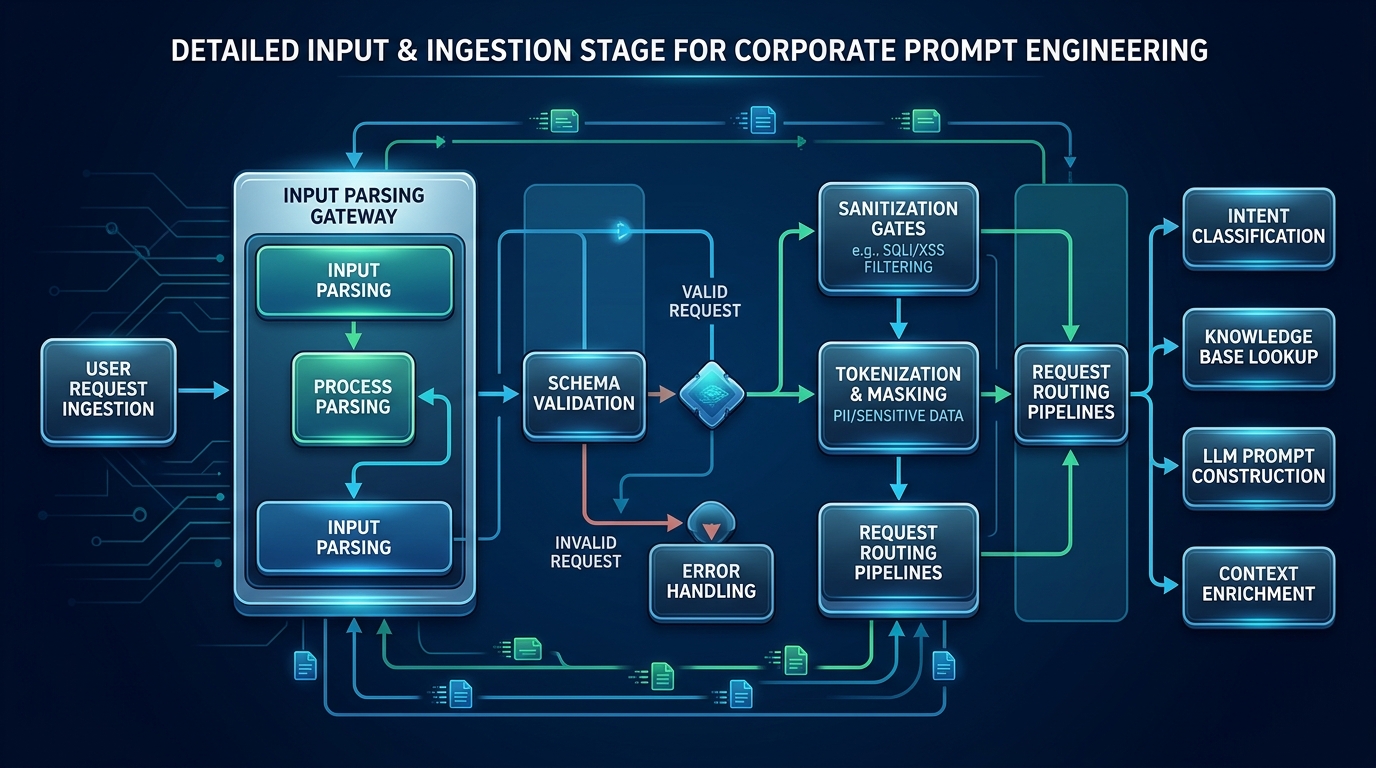
O ecossistema tradicional de microsserviços confia em tipagem estática, contratos OpenAPI rigorosos, esquemas gRPC ou serialização Protocol Buffers para garantir que o serviço A consiga conversar com o serviço B sem surpresas. No entanto, quando introduzimos um LLM no meio do pipeline, injetamos um elemento fundamentalmente não determinístico. O modelo não retorna um objeto estruturado por padrão; ele emite uma sequência de tokens otimizada probabilisticamente para se parecer com a linguagem humana.
Em arquiteturas corporativas, delegar a integridade dos dados ao bom senso do prompt (“por favor, retorne apenas um JSON válido”) é uma falha arquitetural grave. Sem validação estruturada, ocorrem violações de esquema, estouros de memória por alucinação de campos arbitrários e falhas em cascatas nos microsserviços downstream que dependem daquele payload para prosseguir com transações financeiras ou logísticas.
A mitigação desse colapso exige a adoção de abordagens de Structured Output Enforcement, utilizando bibliotecas de validação em tempo de execução combinadas com gramáticas livres de contexto (CFGs) ou chamadas de ferramentas nativas dos provedores de modelos.
Design Patterns para Prompts em Ambientes Distribuídos
Assim como a engenharia de software clássica consolidou padrões de projeto (Design Patterns) para resolver problemas recorrentes de orientação a objetos, a engenharia de prompt corporativa exige a formalização de padrões arquiteturais adaptados para interações com modelos generativos.
1. O Prompt Registry Pattern (Repositório de Prompts Versionados)
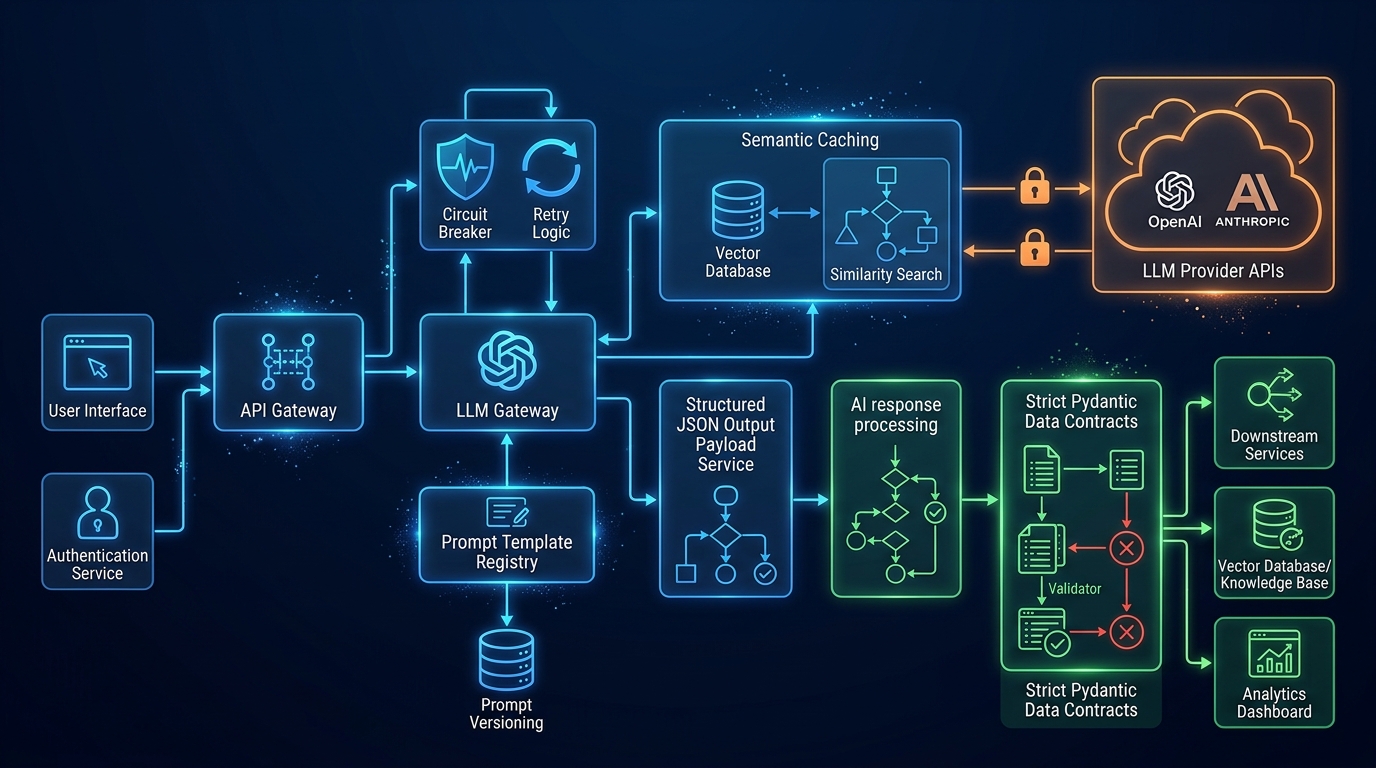
Prompts não devem residir hardcoded dentro da lógica de negócio dos microsserviços. O Prompt Registry Pattern desacopla o artefato textual do código da aplicação. Os prompts são tratados como código de infraestrutura, versionados via Git, testados em pipelines de CI/CD por meio de avaliação contínua (Evaluation-driven Development) e injetados dinamicamente nos serviços através de um microsserviço de configuração centralizado.
2. Context Window Sharding (Fragmentação da Janela de Contexto)
Em cenários corporativos complexos, alimentar o LLM com toda a base de conhecimento de uma empresa gera degradação de atenção (Lost in the Middle). O padrão Sharding divide a ingestão de dados em blocos granulares, utilizando recuperação vetorial (RAG) combinada com roteamento semântico determinístico. O prompt final é montado em camadas: system instructions rígidas, contexto retrieved altamente filtrado e a instrução do usuário isolada em um escopo protegido contra Prompt Injection.
3. Dynamic Few-Shot Selector
Em vez de manter exemplos estáticos dentro do prompt de sistema, este padrão seleciona dinamicamente os exemplos de Few-Shot mais relevantes com base na similaridade de embedding da entrada atual do usuário. Isso otimiza o consumo de tokens e eleva drasticamente a precisão da resposta em tarefas de alta complexidade analítica.
Implementação Prática: Validação Estruturada com Pydantic
Para garantir que a saída de um LLM atenda estritamente aos requisitos contratuais do sistema, acoplamos a chamada do modelo a um framework de validação robusto como o Pydantic. Abaixo, construímos um componente de produção tipado que assegura a tipagem e integridade do payload gerado pela IA antes que ele toque qualquer banco de dados ou serviço crítico.
import os
from typing import List, Literal
from pydantic import BaseModel, Field, ValidationError
from openai import OpenAI

# Inicialização do cliente com boas práticas de ambiente
client = OpenAI(api_key=os.environ.get("OPENAI_API_KEY"))

# 1. Definição estrita do Contrato de Dados (Schema)
class ItemFatura(BaseModel):
    descricao: str = Field(..., description="Descrição detalhada do item ou serviço prestado.")
    quantidade: int = Field(..., gt=0, description="Quantidade deve ser estritamente maior que zero.")
    preco_unitario: float = Field(..., gt=0.0, description="Preço unitário em moeda corrente.")

class FaturaProcessada(BaseModel):
    numero_fatura: str = Field(..., description="Identificador único da fatura no formato INV-XXXX.")
    status_aprovacao: Literal["APROVADO", "REVISAO_MANUAL", "REJEITADO"]
    itens: List[ItemFatura] = Field(..., min_items=1)
    valor_total: float = Field(..., description="Soma total calculada dos itens.")

# 2. Função de Inferência com Validação e Tratamento de Erro (Retry Pattern)
def extrair_fatura_estruturada(texto_bruto: str, max_retries: int = 3) -> FaturaProcessada:
    prompt_sistema = (
        "Você é um motor de extração de dados corporativos altamente preciso. "
        "Analise o texto fornecido e retorne estritamente um JSON que siga "
        "o esquema Pydantic da FaturaProcessada. Não inclua texto adicional fora do JSON."
    )

    for tentativa in range(max_retries):
        try:
            resposta = client.chat.completions.create(
                model="gpt-4o",
                messages=[
                    {"role": "system", "content": prompt_sistema},
                    {"role": "user", "content": texto_bruto}
                ],
                response_format={"type": "json_object"},
                temperature=0.0 # Determinismo máximo para extração
            )

            conteudo_json = resposta.choices[0].message.content

            # Validação estrita em tempo de execução
            fatura_validada = FaturaProcessada.model_validate_json(conteudo_json)
            return fatura_validada

        except (ValidationError, Exception) as e:
            if tentativa == max_retries - 1:
                # Falha definitiva após esgotar tentativas
                raise RuntimeError(f"Falha crítica na validação estruturada do LLM após {max_retries} tentativas: {e}")
            continue

# Exemplo de uso simulado em ambiente de produção
if __name__ == "__main__":
    texto_entrada = "Fatura INV-9928: Consultoria de Arquitetura Cloud (20 horas a R$ 150.0 cada)."
    try:
        fatura = extrair_fatura_estruturada(texto_entrada)
        print("Sucesso na ingestão:", fatura.model_dump_json(indent=2))
    except Exception as err:
        print(f"Erro operacional capturado: {err}")
Arquiteturas de Produção e Trade-offs Operacionais
Implementar IA generativa em escala exige equilibrar três vetores fundamentais: latência de inferência, custo computacional por requisição e nível de acurácia determinística. A tabela abaixo detalha os trade-offs reais enfrentados por arquitetos de software ao desenhar pipelines corporativos de LLM.
| Dimensão Arquitetural | Abordagem Baseada em API de Terceiros (ex: GPT-4o) | Abordagem Local com Open-Source (ex: Llama 3 70B) | Abordagem Híbrida / Roteamento Dinâmico |
|---|---|---|---|
| Latência Média (TTFT) | Moderada a Alta (depende da rede e fila do provedor) | Baixa a Moderada (controlada pela infraestrutura própria) | Otimizada (modelos menores para tarefas simples, pesados para complexas) |
| Custo Operacional | Variável por volume de tokens (Capex zero, Opex alto) | Alto custo de infraestrutura GPU (Capex alto, Opex previsível) | Equilibrado (roteamento inteligente reduz custos globais) |
| Governança e Privacidade | Dados trafegam por infraestrutura externa (exige acordos de LGPD/SOC2) | Controle total e soberania absoluta sobre os dados corporativos | Segmentação de dados sensíveis para instâncias locais |
| Complexidade de Engenharia | Baixa (foco apenas na aplicação e integração de API) | Altíssima (orquestração de clusters vLLM, quantização, scaling) | Alta (requer camada proxy de roteamento semântico) |
Resiliência contra alucinações e circuit breaking
Sistemas distribuídos que integram LLMs estão sujeitos a falhas sistêmicas inéditas. Quando um provedor de IA sofre uma interrupção parcial, suas requisições podem começar a retornar erros 500 ou travar por estouro de timeout, degradando toda a experiência do usuário final.
Para blindar a aplicação corporativa, a camada de integração de IA deve implementar padrões clássicos de resiliência de engenharia de software:
- Circuit Breakers (Disjuntores): Se a taxa de erro de inferência ou latência ultrapassar um limiar crítico (ex: 5% de falhas em uma janela de 60 segundos), o disjuntor desarma, impedindo que o sistema continue inundando o provedor com chamadas fadadas ao fracasso e acionando fallbacks automáticos (como modelos menores locais ou respostas cacheadas).
- Semantic Caching: Consultas semelhantes enviadas por diferentes usuários não devem disparar novas chamadas caras e lentas à API do LLM. O uso de um cache baseado em distância vetorial em memória (como Redis com RediSearch) permite recuperar respostas validadas anteriormente com latência inferior a 10 milissegundos.
- Fallbacks emCascata: Se o modelo primário de alta inteligência falhar na validação do Pydantic após múltiplos retries, o gateway de prompt pode reescrever a requisição direcionando-a para um modelo secundário de menor custo e maior previsibilidade sintática.
Telemetria, Observabilidade e Governança Contínua
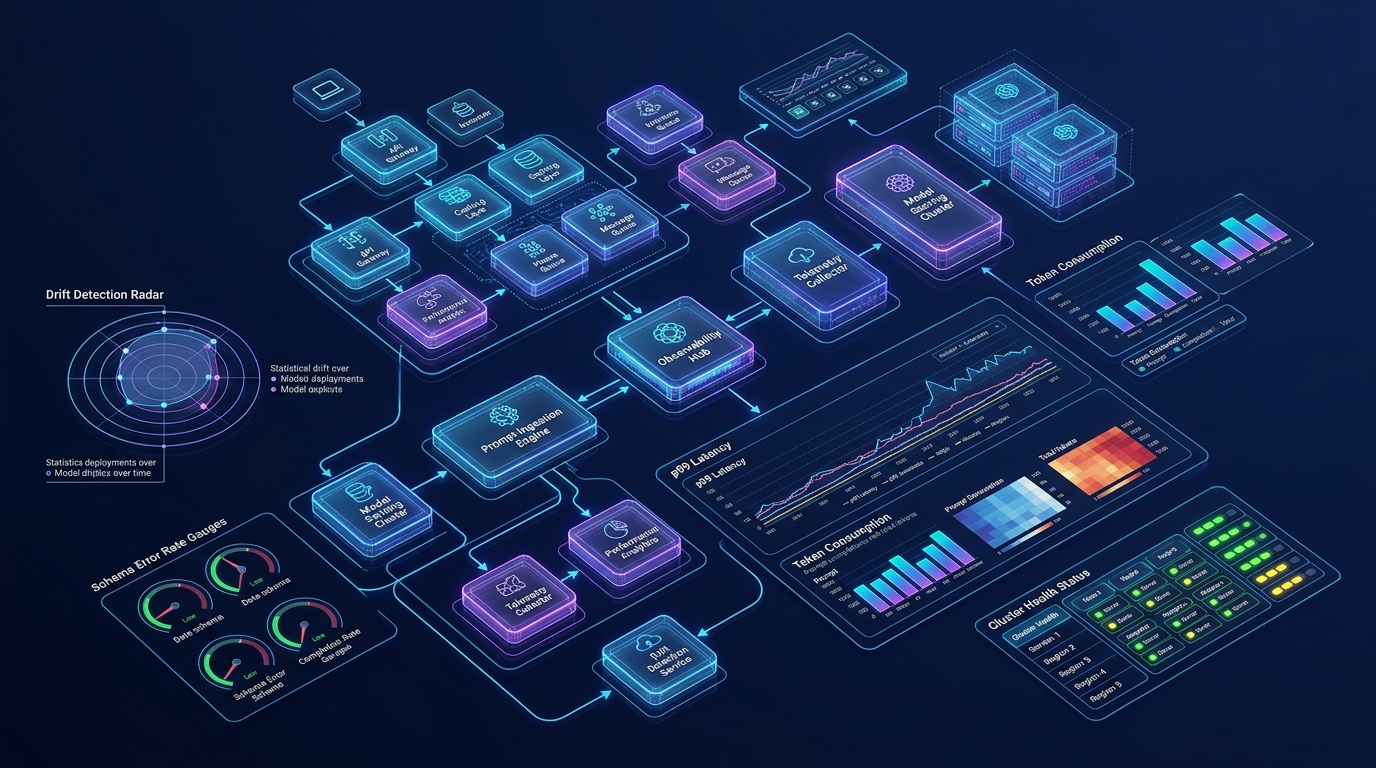
Não é possível gerenciar o que não se mede. Em ambientes corporativos de alta criticidade, a observabilidade de IA vai muito além de métricas tradicionais de infraestrutura como uso de CPU e memória. É imperativo monitorar métricas de negócio e de comportamento do modelo em tempo real:
- Tokens por Segundo (Throughput): Essencial para planejar o dimensionamento de custos e prever gargalos de concorrência.
- Taxa de Rejeição de Schema (Validation Error Rate): Indica o quão estável o modelo está sendo em respeitar os contratos de dados definidos nos prompts de sistema.
- Derrapagem Semântica (Semantic Drift): Monitoramento contínuo de embeddings para detectar quando atualizações silenciosas de modelos por parte dos provedores alteram o comportamento das respostas corporativas.
A maturidade na engenharia de prompt não se resume a escrever frases eloquentes ou truques de formatação textual. Trata-se de construir uma disciplina rigida de desenvolvimento de software, onde o prompt é um componente observável, testável, versionável e fortemente tipado, garantindo que a inteligência artificial atue como um pilar confiável e escalável na arquitetura corporativa.