A Anatomia do Acoplamento Oculto e a Ilusão da Resiliência
Sistemas distribuídos modernos frequentemente mascaram problemas estruturais sob uma fachada de microsserviços independentes. No entanto, quando a carga transacional escala de forma não linear, o calcanhar de Aquiles de qualquer ecossistema de software surge na camada de comunicação. O modelo síncrono baseado em HTTP/REST ou gRPC falha miseravelmente sob picos de latência em cascata. É exatamente neste cenário crítico que a engenharia de mensageria assíncrona deixa de ser uma mera opção de design e se torna a fundação inegociável da continuidade operacional.
A adoção de brokers de mensagens não é uma bala de prata. Escolher entre a flexibilidade baseada em roteamento do RabbitMQ e o paradigma de stream imutável do Apache Kafka exige uma compreensão profunda dos trade-offs subjacentes. Um erro de projeto na escolha do mecanismo de entrega pode resultar em perda de dados catastrófica, gargalos de rede invisíveis ou loops infinitos de reprocessamento que paralisam a infraestrutura corporativa.
O objetivo deste artigo é desconstruir os padrões arquiteturais avançados que regem o RabbitMQ e o Apache Kafka. Vamos analisar gargalos reais em ambientes de produção, discutir estratégias de particionamento, políticas de Dead Letter Queues (DLQ), garantias de entrega (at-least-once, at-most-once, exactly-once) e como estruturar contratos de dados resilientes utilizando Python altamente tipado.
Desmistificando o Tráfego de Borda e os Desafios de Ingestão
Na camada de ingestão de dados de alta volumetria, o primeiro grande obstáculo é absorver rajadas (bursts) de tráfego sem saturar os recursos de computação dos nós receptores. Sistemas legados que tentam processar eventos síncronamente durante picos de acesso sofrem com esgotamento de conexões (connection pool exhaustion) e estouro de pilha de memória.
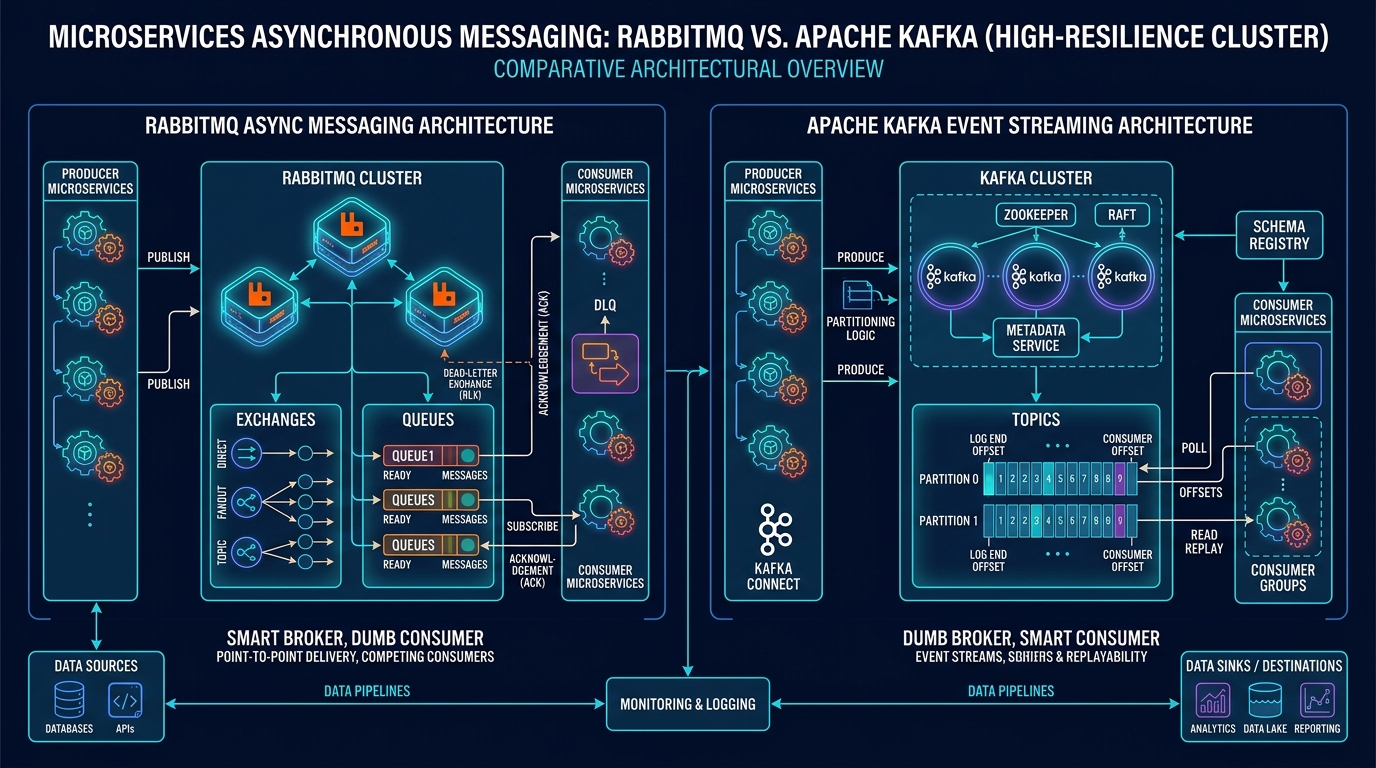
O RabbitMQ brilha nesta camada quando o requisito central envolve roteamento complexo, troca de mensagens baseada em tópicos flexíveis (topic exchanges) e processamento orientado a tarefas de curta duração. Sua arquitetura baseada em AMQP (Advanced Message Queuing Protocol) permite que produtores enviem mensagens para um exchange, que por sua vez as distribui para filas baseadas em regras de correspondência (bindings).
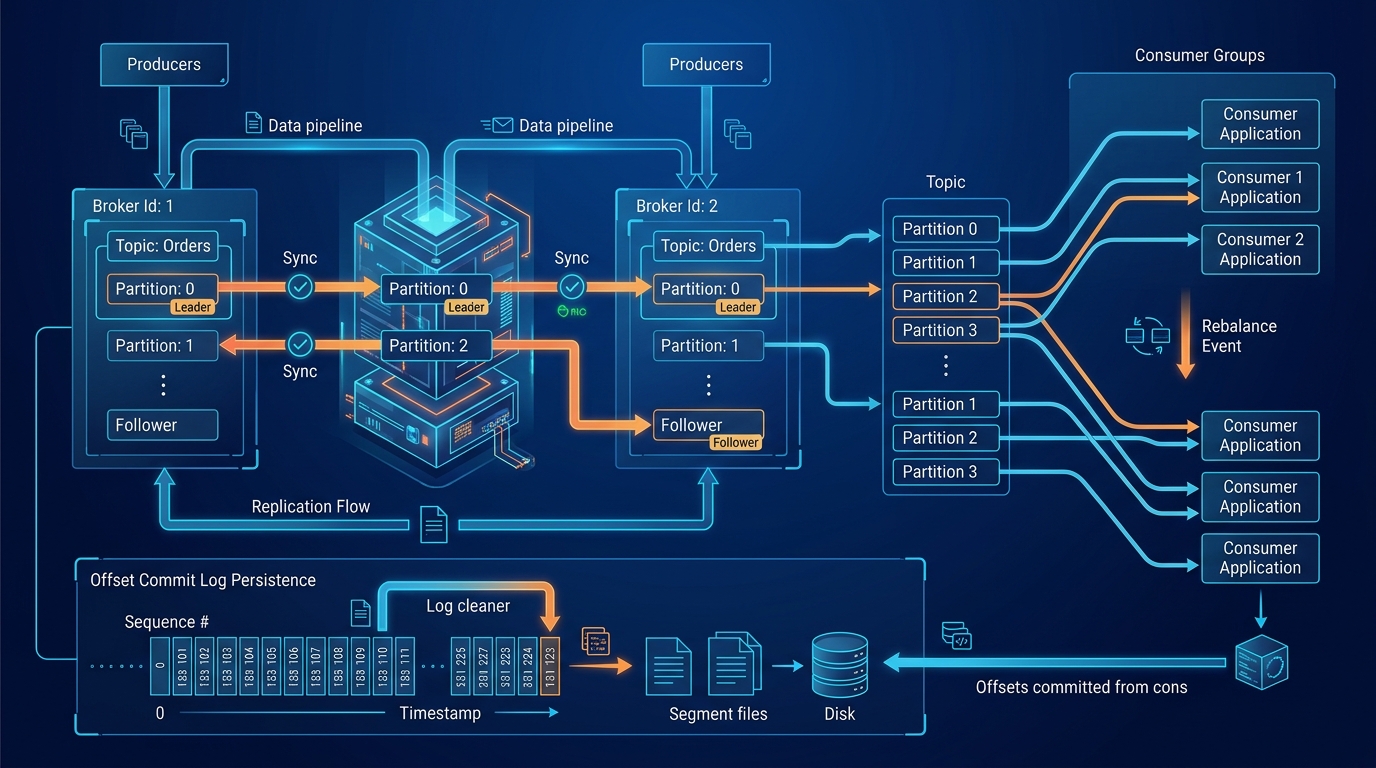
Por outro lado, o Apache Kafka aborda a ingestão sob uma ótica fundamentalmente distinta: o Commit Log distribuído. No Kafka, o foco não é o roteamento dinâmico de tarefas individuais, mas a persistência sequencial e imutável de fluxos contínuos de dados. Os produtores escrevem em partições específicas dentro de tópicos, garantindo ordenação estrita por chave e permitindo que múltiplos consumidores leiam o mesmo stream em diferentes velocidades sem destruir o estado histórico.
O Dilema dos Protocolos: AMQP vs. Commit Log
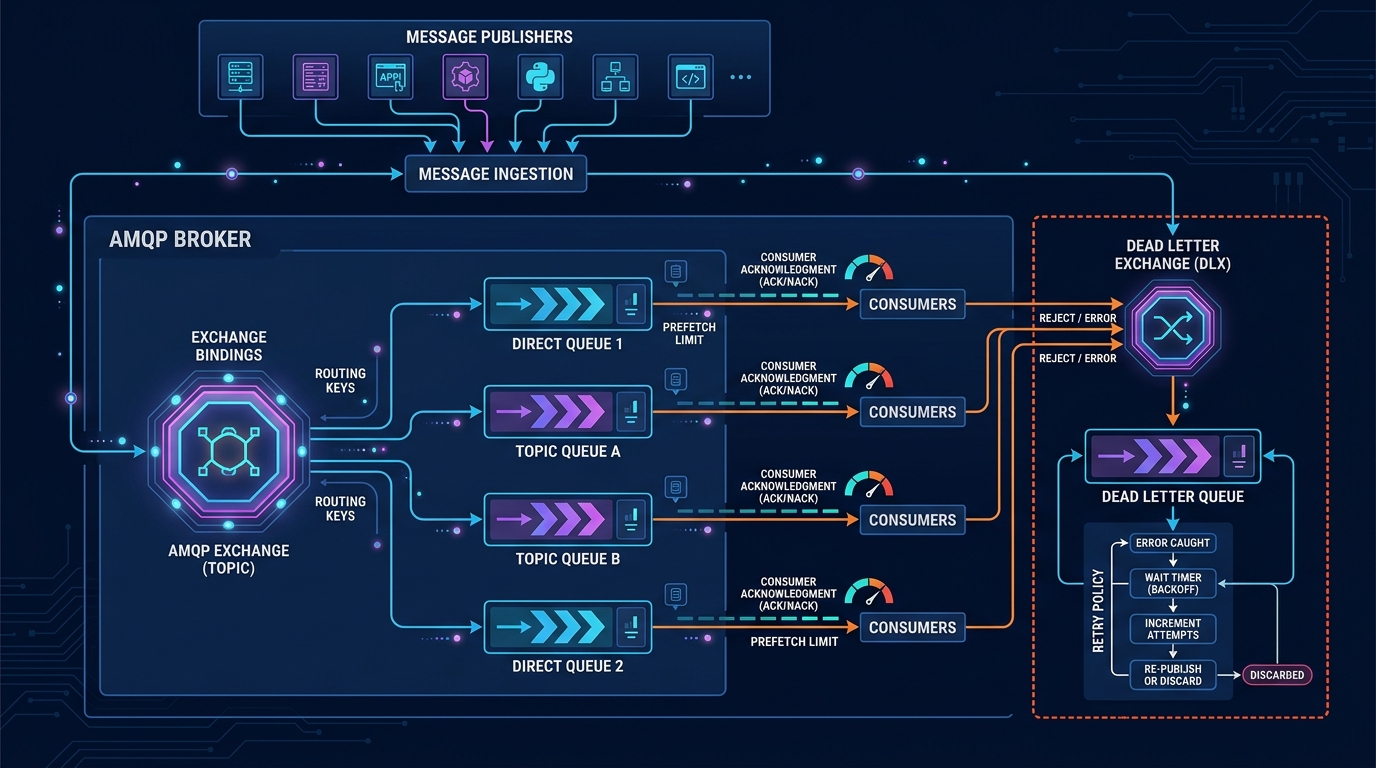
Para arquitetar sistemas de alta resiliência, é imperativo compreender as diferenças fundamentais entre o modelo de filas tradicionais e o modelo de logs de eventos:
| Dimensão Arquitetural | RabbitMQ (AMQP / Smart Broker) | Apache Kafka (Distributed Log / Dumb Broker) |
|---|---|---|
| Modelo de Armazenamento | Mensagens são removidas após o reconhecimento de consumo (ACK). | Mensagens persistem em disco por retenção de tempo ou tamanho, independente do consumo. |
| Roteamento | Complexo e flexível via Exchanges (Direct, Topic, Fanout, Headers). | Simples, baseado em partições de tópicos e chaves de hash. |
| Garantia de Ordenação | Garantida apenas em filas de consumidor único; paralelizá-la quebra a ordem. | Garantida estritamente dentro de cada partição de um tópico. |
| Casos de Uso Ideais | Fila de tarefas assíncronas, processamento em background, webhooks, roteamento complexo. | Event streaming, microsserviços orientados a eventos, CQRS, pipelines analíticos em tempo real. |
Implementando Produtores e Consumidores Resilientes com Python
A teoria arquitetural precisa ser traduzida em código robusto. Abaixo, apresentamos uma implementação em Python utilizando tipagem estrita (pydantic para contratos de dados e pika para integração com RabbitMQ). O código demonstra como estruturar uma camada de publicação resiliente com tratamento de exceções transacionais e serialização validada.
import json
import logging
from typing import Any, Dict
import pika
from pika.exceptions import AMQPConnectionError, ChannelError
from pydantic import BaseModel, Field, ValidationError

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(name)s: %(message)s")
logger = logging.getLogger("ZehroMessenger")

class TelemetryEvent(BaseModel):
    event_id: str = Field(..., description="UUID universal do evento")
    source_service: str = Field(..., min_length=2)
    payload: Dict[str, Any]
    timestamp: float = Field(..., gt=0)

class RabbitMQPublisher:
    def __init__(self, host: str, queue_name: str):
        self.host = host
        self.queue_name = queue_name
        self.connection = None
        self.channel = None
        self._connect()

    def _connect(self) -> None:
        try:
            parameters = pika.ConnectionParameters(host=self.host, heartbeat=600, blocked_connection_timeout=300)
            self.connection = pika.BlockingConnection(parameters)
            self.channel = self.connection.channel()

            # Declaração de fila durável com suporte a Dead Letter Exchange (DLX)
            self.channel.queue_declare(
                queue=self.queue_name,
                durable=True,
                arguments={
                    'x-dead-letter-exchange': 'dlx.events.exchange',
                    'x-dead-letter-routing-key': 'dlq.events.routing'
                }
            )
            logger.info(f"Conexão estabelecida com sucesso na fila durável: {self.queue_name}")
        except AMQPConnectionError as e:
            logger.error(f"Falha crítica de conexão com o broker RabbitMQ: {e}")
            raise

    def publish_event(self, event: TelemetryEvent) -> bool:
        try:
            # Validação estrita do contrato de dados via Pydantic
            serialized_body = event.model_dump_json()

            if self.connection.is_closed or self.channel.is_closed:
                logger.warning("Conexão perdida detectada. Tentando reconectar...")
                self._connect()

            self.channel.basic_publish(
                exchange='',
                routing_key=self.queue_name,
                body=serialized_body,
                properties=pika.BasicProperties(
                    delivery_mode=2,  # Torna a mensagem persistente em disco
                    content_type='application/json'
                )
            )
            logger.info(f"Evento {event.event_id} publicado com sucesso.")
            return True

        except (ValidationError, ValueError) as ve:
            logger.error(f"Erro de validação do contrato de dados: {ve}")
            return False
        except (ChannelError, AMQPConnectionError) as ce:
            logger.error(f"Erro de canal ou conexão durante a publicação: {ce}")
            # Em cenários corporativos avançados, implementar Circuit Breaker aqui
            return False

if __name__ == "__main__":
    import time
    publisher = RabbitMQPublisher(host="localhost", queue_name="telemetry.ingest.queue")

    sample_event = TelemetryEvent(
        event_id="f47ac10b-58cc-4372-a567-0e02b2c3d479",
        source_service="edge-gateway-alpha",
        payload={"cpu_usage": 88.4, "memory_allocated_mb": 4096},
        timestamp=time.time()
    )

    publisher.publish_event(sample_event)
Estratégias de Mitigação de Falhas: DLQ e Poison Messages
Em sistemas de alta resiliência, assumir que o consumidor sempre processará a mensagem com sucesso é um erro fatal. Mensagens malformadas ou falhas transitórias em bancos de dados dependentes podem gerar o temido fenômeno da Poison Message: uma mensagem que falha repetidamente, consumindo ciclos de CPU e travando o worker indefinidamente.
Para mitigar este risco, tanto o RabbitMQ quanto o Kafka exigem uma arquitetura defensiva baseada em:
- Dead Letter Queues (DLQ): Quando uma mensagem atinge o limite máximo de tentativas de entrega (max-delivery-count) ou é rejeitada explicitamente sem requisição de re-enfileiramento (
basic_rejectcomrequeue=False), ela é redirecionada automaticamente para uma exchange secundária isolada. - Backoff Exponencial com Jitter: Em vez de reprocessar mensagens instantaneamente após uma falha de conexão com o banco de dados, os consumidores devem aplicar atrasos crescentes combinados com aleatoriedade controlada (jitter). Isso evita o efeito thundering herd, onde centenas de workers tentam reconectar simultaneamente, derrubando o banco de dados de destino de vez.
Observabilidade, Telemetria e Métricas de Produção
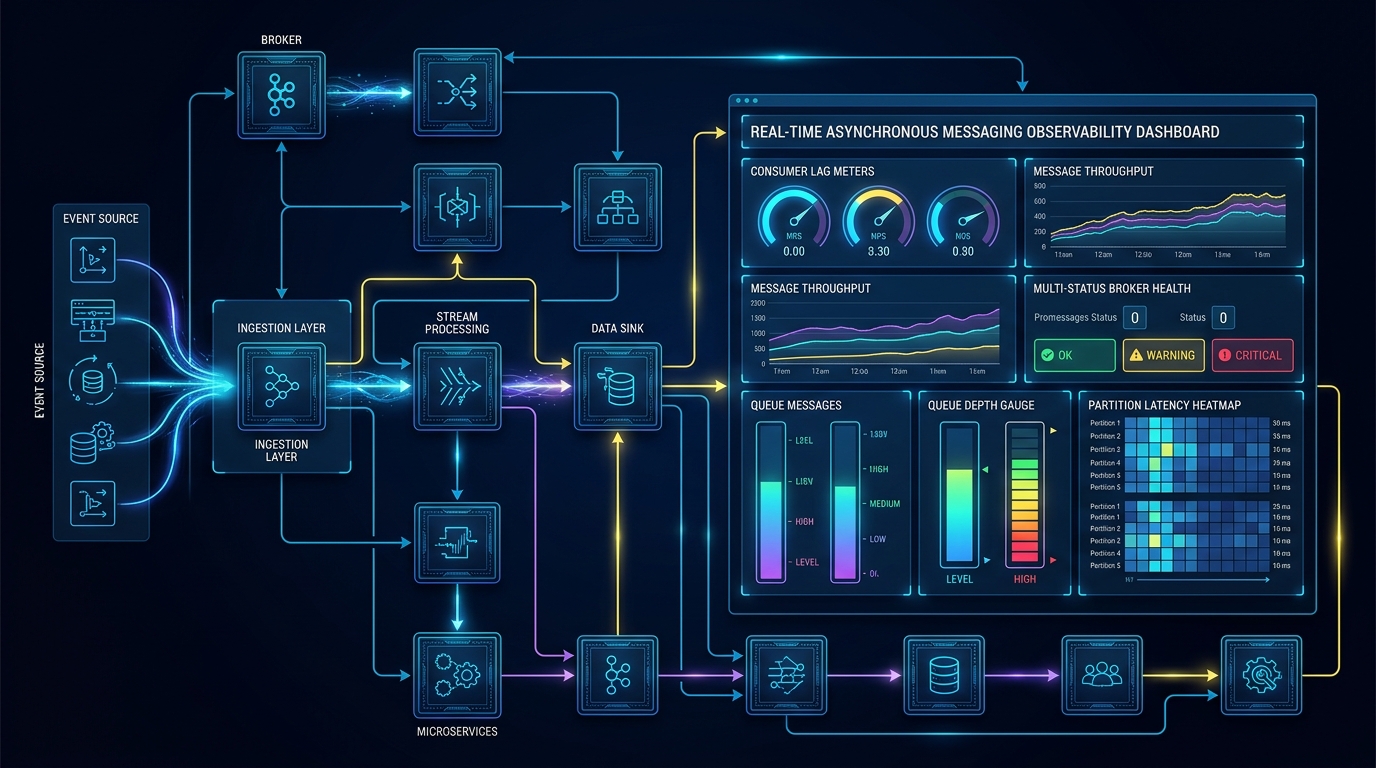
Gerenciar sistemas assíncronos sem uma camada de observabilidade madura é navegar às cegas em uma tempestade. Em ambientes de produção corporativa, o monitoramento não deve se limitar ao uso de CPU e memória dos containers do broker. As métricas cruciais residem no comportamento do fluxo de dados.
As principais métricas que exigem alertas parametrizados em ferramentas como Prometheus e Grafana incluem:
- Consumer Lag: O indicador mais crítico em Apache Kafka. Representa a diferença entre o deslocamento (offset) atual produzido na partição e o deslocamento consumido pelo grupo de consumo. Um lag crescente indica que os consumidores estão subdimensionados ou travados.
- Message Throughput (Ingress vs. Egress): A taxa de mensagens publicadas por segundo em comparação à taxa de mensagens reconhecidas ou consumidas. Discrepâncias prolongadas apontam estrangulamentos na lógica de negócio.
- Unacked Messages (RabbitMQ): O número de mensagens entregues aos consumidores que ainda não receberam um
basic_ack. Valores elevados indicam que os consumidores estão presos em operações bloqueantes ou deadlocks. - DLQ Influx Rate: A taxa de mensagens direcionadas às filas de erro. Um pico súbito nesta métrica geralmente sinaliza uma quebra de contrato de dados após um deploy de microsserviço sem versionamento adequado.
Conclusão Operacional
A engenharia de mensageria assíncrona exige rigor analítico. A escolha entre RabbitMQ e Apache Kafka não deve ser ditada por modismos tecnológicos, mas por restrições arquiteturais reais: roteamento dinâmico e flexibilidade de tarefas versus persistência imutável e fluxos de dados de alta escala. Ao projetar contratos estritos, blindar a aplicação contra poison messages e monitorar implacavelmente o consumer lag, constrói-se um ecossistema distribuído verdadeiramente resiliente, capaz de absorver falhas sem perder uma única transação corporativa.